#netzkultur (582)

Seite 3 von 59

Ad Infinitum / Zu Googles angekündigter AI-Suche

Matthias fast zusammen, was Google eigentlich auf seiner AI-durchtränkten I/O-Keynote – hier der 54 Sekunden lange AI-Supercut – angekündigt, aber nicht explizit gesagt hat: Nämlich dass sie ihre bisherigen Quellen – das Open Web – und das eigene Geschäfts­modell – die Werbelinks in den Suchergebnis­seiten – zugunsten von generativen UIs mit AI-Antworten und dort einge­betteten AI-Ads opfern.

Was das wiederum für Webpublikationen bedeutet, wenn die „ten blue links“ nun offiziell vorbei sind, beschreibt Sascha sehr eindringlich.

Ob Googles AI-Suche allerdings so angenommen werden wird, steht auf einem anderen Blatt. Studierende buhen AI-Befürworter aus, Menschen verurteilen AI-verursachte (oder -begründete) Entlassungen, hassen AI-Rechenzentren und „what if people don’t actually want to use search this way?“, wie Matthias auch eingangs fragt. Zumindest letzteres scheint seit den ersten ChatGPT-Versionen jedoch beantwortet zu sein: Antworten, die keine Website-Aufrufe erfordern, werden gut und gerne in LLMs genutzt. Das wird (leider) auch so bleiben.

Meine langfristige These daher: Das „Web“ wird bei Google & Co. nur noch ein untergeordneter Tab/Reiter sein. So wie „Bilder“ und „Nachrichten“ heute und, *hust*, das Usenet zuvor. „Kaufen Sie sich hier unbegrenzten Zugriff auf das World Wide Web für nur 19,99 Euro/Monat!“

—

Aber denkt dran, [hier bitte meinen obligatorischen Hinweis auf Kagi als bessere, privatere Suchmaschine einsetzen; auch wenn das natürlich nur eine Lösung für besagte digitale Bohème sein wird].
Ad Infinitum · Matthias Ott | OpenGraph Preview Image
matthiasott.com

Ad Infinitum · Matthias Ott

Web design engineer, UX designer, teacher, and speaker – helping teams build websites and digital products with a focus on CSS, accessibility, and performance.

This is where my tech comes from

Kleines Tool von Martin Holland, um sich einen Überblick zu verschaffen, woher die selbst genutzte Software in den größten Kategorien (OS, Browser, Messaging, usw.) kommt. Und um das gleich auf Social Media zu teilen. Bei mir – oh je, nicht teilbar – sind’s immer noch 79% 🇺🇸.

Der nächste Di-Day kann also gar nicht früh genug kommen.

Tech Origin | OpenGraph Preview Image
fingolas.eu

Tech Origin

Select the software you use — a ready-to-copy text showing their origin will be generated automatically.

personalsit.es – Directory of Personal Websites

This site was built to share and revel in each others‘ personal sites, and is currently home to ~1003 of them. Witness these in wonderment and awe. Immaculate. Stunning. How did they do that? Yes, you should definitely get around to redesigning yours soon.

Ich bin gestern auf diesen Post von Declan Chidlow gestoßen, der erwähnte, das personalsit.es, eine Sammlung von, nun ja, Personal Websites, nun über eintausend Einträge umfasst. Das Directory ist mir auch schon lange bekannt und ich gucke immer mal wieder gerne rein, um zu sehen, wie die Websites anderer Leute aussehen, aber dann ist mir bewusst geworden, dass ich hier noch nie darauf verlinkt habe, was ich hiermit nachhole, denn wir ihr wisst, bin ich Fan davon, wenn einjede*r ein eigenes Stückchen Internet besitzt.

Und sobald meine persönliche Website gelauncht wurde, reiche ich die dann auch hier ein. 😌

PersonalSit.es | OpenGraph Preview Image
personalsit.es

PersonalSit.es

Personal sites are sick as hell, so this site was built so we can all discover each other's. This directory of links are by folks that want to share their site with the world.

What now-familiar domain names looked like before they were bought by big-time companies

Jason Kottke weist auf diesen schönen Bluesky-Thread von Annie Rauwerda hin, in dem sie berichtet, was vorher auf den Domains von jetzt bekannten Firmen passierte:

What now-familiar domain names looked like before they were bought by big-time companies, e.g. openai.com was „the personal homepage of a guy named glenn“, doordash.com was a porn site, threads.com sold spools of thread.

Ihr Resümee ist dann auch sehr treffend:

before the internet was a corporate hellscape it was built by ordinary people!

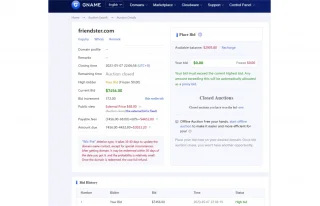
I bought Friendster for $30k – here’s what I’m doing with it

Das 2002 gestartete Friendster war eines der ersten Social Networks und das erste, das über eine Millionen Nutzer*innen hatte, was bis 2011 sogar bei 115 Millionen Usern peakte. Hier ein früher Einblick durch das Web Design Museum. 2015 war aber auch schon wieder Schluss während andere Netz­werke den Markt dominierten.

Web-Entrepreneur Mike Carson1, der, wie er selbst angibt, seine Frau auf OkCupid kennengelernt hat und damit die Gründung seiner Familie Online-Services verdankt, verleiht Friendster nun neues, wenn auch anderes Leben ein. So hat er sich friendster.com samt auslaufendem Friender-Trademark gekauft und eine kleine Social-Networking-App darauf gestartet, allerdings mit dem Clou, dass die Nutzer*innen sich zunächst offline connecten müssen. Was 2026 wahrlich keine schlechte Idee ist. (via Kottke)

—

Welche Online-Dienste und Apps würdet ihr denn gerne wieder aus der Versenkung holen?

Bei mir wäre es ganz klar das klassische Gowalla (2007), eine frühe, spaßige Check-In-App, die dann von Meta Facebook gekauft wurde (und die seitdem meine Daten in Geiselhaft halten!), und Placescore (2014), ein spaßiges, ortsgebundenes Puzzle-Spiel mit Bestenlisten von Marcel & Team.

  1. Name (≠ Handle) auf X ist „mike@bitcoin“, was gleich zwei Red Flags sind, also bitte mit Vorsicht genießen. [↩]
I bought Friendster for $30k – here's what I'm doing with it | OpenGraph Preview Image
ca98am79.medium.com

I bought Friendster for $30k – here's what I'm doing with it

Friendster was the first social network. It has a long history, but the website friendster.com went dead in 2015 and the company officially shut down three years later in 2018. That’s where this story begins.

Bluesky Feed for beyond tellerrand

Ich bin gerade endlich wieder auf der beyond tellerrand, die in diesem Jahr 15 jähriges Bestehen feiert, nachdem ich das letzte Mal von 2016 bis 2018 hier war und eine Post-Corona-Wiederaufnahme in 2022 kurzfristig scheiterte.

Damals™ 2016-2018 stellte Twitter noch den dominanten digitalen Rückkanal dar, heute wird das verteilt auf Mastodon, Bluesky, Threads und Instagram. Während davon alle die Suche nach Hashtags wie #btconf ermöglichen, hat Bluesky bekanntlich noch ein cooleres Feature: Custom Feeds, also Timelines, die man nach Belieben algorithmisch zusammenstellen kann. Und nach dem FC-Köln-News-Feed habe ich das nun mit dem beyond tellerrand Bluesky-Feed gemacht, der den offiziellen Account, „beyond tellerrand“-Mentions und besagten Hashtag in einer Timeline vereint.

Überaus nett, wenn man auf der Konferenz sitzt (oder von anderswo zuschaut) und man sehen will, was andere so denken und umtreibt.

beyond tellerrand by @eay.social | OpenGraph Preview Image
bsky.app

beyond tellerrand by @eay.social

The unofficial Bluesky timeline for beyond tellerrand: talks, side events, design, code, typography, creativity, and the web.

Own Your Web – Issue 18: Curators

Nach einer etwas längeren Pause ist der hier auch schon empfohlene Newsletter Own Your Web von Matthias Ott zurück mit einer Ausgabe über „Curators“. Denn das Kuratieren wird in Anbetracht des noch anwachsenden AI-Slops um uns herum noch wichtiger, wie Matthias schreibt:

So what becomes valuable, in a world like this? Not more content. We are drowning in content. What becomes valuable is someone you trust, saying: This is worth your time. Here’s why.

That’s curation. And it’s not new.

Und als jemand, der einen Großteil seines privaten Onlinelebens genau damit verbringt, wird es euch wenig verwundern, dass ich diese Ansicht teile. „Aber wieviel auf andere Inhalte zeigen, passiert hier eigentlich?“ habe ich mich im Zuge dessen gefragt und mal kurzerhand das Archiv analysiert. Und siehe da:

  • Seitdem ich die Post-Typen hier eingeführt habe, sind 53,10 % aller Posts Link-Posts; insgesamt 1.227 (vor diesem).
  • Aber auch schon davor wurde rege verlinkt, denn insgesamt 3.693 Posts der bisher 4.318, also insgesamt 85,53 %, verlinken auf externe Quellen.
  • Dabei habe ich insgesamt 11.843 externe Links von 3.350 unter­schied­lichen Domains verlinkt.

In a web full of noise, that act of caring – of curare – might be the most important signal any of us can send.

Exakt. Also freut euch auf viele weitere, handverlesene Links hier. 😌

Own Your Web – Issue 18: Curators | OpenGraph Preview Image
newsletter.ownyourweb.site

Own Your Web – Issue 18: Curators

Hi All! 🤗 The Latin word curare means “to take care of.” It’s the root of curator – a person whose work is not to create, but to care. To select, to arrange,...

Launching XOXO Explore

Zwei Jahre nach dem Ende des XOXO Festivals, das von 2012 bis 2019 und 2024 „independent artists and creators from the internet“ zelebrierte, haben Andy & Andy zusammen mit Collin Joyce und Friends of the Web eine Website fertiggestellt, die das umfassende Archiv an herausragenden Talks zentral zugänglich macht. Das Stöbern darin lohnt sich; im hiesigen #xoxo-Tag finden sich auch ein paar Empfehlungen.

Update, 01.05.2026: Andy Baio hat in seinem Blog auch noch ein paar Worte zum XOXO-Archiv geschrieben.

Launching XOXO Explore · Blog · XOXO | OpenGraph Preview Image
xoxofest.com

Launching XOXO Explore · Blog · XOXO

We launched a complete archive of all eight years of the festival, along with a limited-edition merch collection to mark the occasion.

Dritter Versuch: Bundesregierung beschließt anlasslose Vorratsdatenspeicherung

Die Bundesregierung nimmt einen dritten Anlauf zur Vorrats­daten­speicherung. Internet-Zugangs-Anbieter sollen IP-Adressen aller Nutzer speichern – anlasslos und massenhaft. Internet-Dienste wie E-Mails und Messenger müssen auf Anordnung ebenfalls Daten speichern und herausgeben.

Das ist bereits das dritte Gesetz zur Vorrats­daten­speicherung in Deutsch­land. Sowohl das erste Gesetz von 2007 als auch das zweite Gesetz von 2015 wurden von höchsten Gerichten gekippt.

Sieht aus als bekäme jedes Jahrzehnt seinen Versuch zur Vorrats­daten­speicherung. Was wohl dieses Mal passiert?

Dritter Versuch: Bundesregierung beschließt anlasslose Vorratsdatenspeicherung | OpenGraph Preview Image
netzpolitik.org

Dritter Versuch: Bundesregierung beschließt anlasslose Vorratsdatenspeicherung

Die Bundesregierung nimmt einen dritten Anlauf zur Vorratsdatenspeicherung. Internet-Zugangs-Anbieter sollen IP-Adressen aller Nutzer speichern - anlasslos und massenhaft. Internet-Dienste wie E-Mails und Messenger müssen auf Anordnung ebenfalls Daten speichern und herausgeben.